发布时间:2026-11-10 来源:IT之家
根据官方介绍,该模型也是行业首个具身全模态端到端交互大模型。WITA-Omni 基于机器人本体感知数据深度训练,除了音视频输入输出,还新增支持触觉、本体状态等输入,以及机器人动作、表情等输出,让机器人第一次拥有为物理世界而生的“交互大脑”。
基于流式全双工架构,WITA-Omni 可做到边听、边想、边应、边动、边做表情,减少传统串行处理中的等待。交互响应最快约 400 毫秒、平均约 600 毫秒,较业内平均水平快近 3 倍。
同时,全模态拒识让机器人交互不再需要唤醒词,全程自然对话。系统结合对话朝向、视频、音频、声纹、唇动、姿态、语义和上下文,决策当前发言是否需要回应。面对多人交谈或环境广播等干扰时,极大降低误触发,让机器人更懂“看场合”。
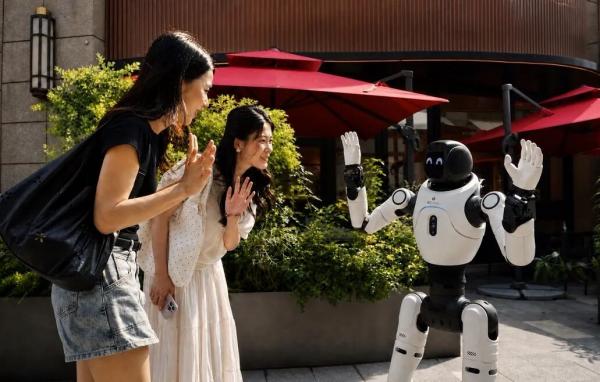
WITA-Omni 支持上百种语言和方言的免切换自由交流,并结合全双工架构,实现了流式同声传译(语言传译 & 方言传译),以及双向互译。
WITA-Omni 情感表现力更加拟人。倾听时,机器人能够通过细腻的表情和自然的头部动作给予回应;表达时,结合参数化的面部表情、富有感染力的声音与协调的肢体动作,生动呈现开心、惊讶、激动、悲伤、满意、痛哭、认真与自信等几十种情绪。每种情绪还能展现不同强度:同样是开心,既可以浅浅一笑,也可以开怀大笑,让对话更真实、更有温度。
WITA-Omni 不仅能说、能看、能动,还能画。例如,想讲一个复杂产品时,或想给孩子讲一个科普小知识时,WITA-Omni 会智能决策,将一言难尽的内容在面部屏幕实时可视化出来,让用户一目了然。
据IT之家此前报道,今年 7 月,WITA-Omni Preview 模型以 85.21 分综合成绩登顶登顶 DailyOmni 全模态理解榜单,超过千问、Gemini、豆包、英伟达等国内外领先模型,并在八项细分指标中的六项取得第一。
《全球第一,智元 WITA-Omni Preview 具身大模型登顶 DailyOmni 全模态理解榜单》